Aujourd’hui, une grande partie des « IA en production » consiste à demander à un LLM de répondre par oui ou par non. Ce ticket est-il urgent ? Cette facture est-elle conforme ? Ce dossier doit-il partir en revue humaine ? On utilise un modèle conçu pour écrire des paragraphes, en le contraignant à générer du JSON. Ce n’est pas son comportement prévu : on n’obtient le résultat voulu que par la contrainte, puis on parse, on valide, et on espère qu’il n’a pas inventé une catégorie au passage.
TypeSafe AI a ouvert la voie avec Jev, premier modèle de ce type (baptisé « System One »), et une nouvelle catégorie est née : les decision models. Cloudflare avec Clef, puis Liquid AI avec d1, ont repris l’approche dans les semaines qui ont suivi. Même idée de fond : un modèle qui ne génère pas de texte, mais qui renvoie directement une décision typée, avec sa probabilité, en quelques dizaines de millisecondes.
Cet article explique ce que c’est, en quoi ça diffère d’un LLM, où ça bat les LLM, où ça ne sert à rien, et ce que ça coûte.
Qu’est-ce qu’un decision model ?
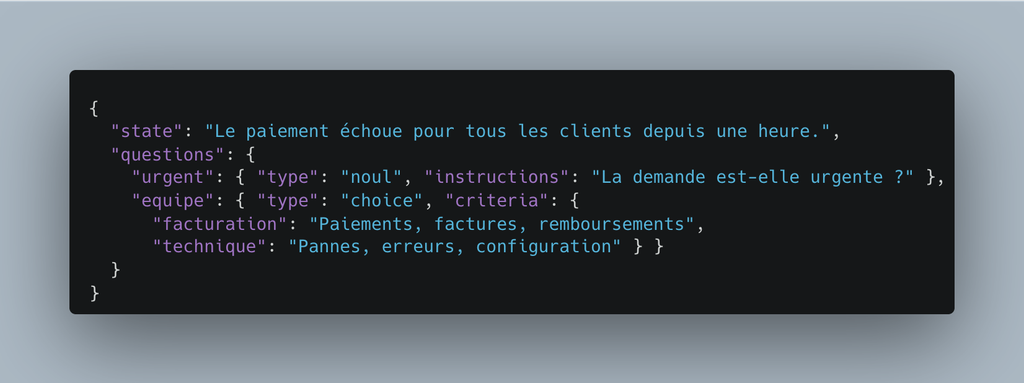
Un decision model prend en entrée un état (du texte, du JSON, une image, parfois une vidéo) et un schéma de questions typées. Il renvoie, pour chaque question, une probabilité sur chacune des réponses autorisées.
Les questions suivent trois types :
noul: vrai ou faux (« ce ticket est-il urgent ? »)choice: une option parmi une liste nommée (« quelle équipe doit le traiter : facturation, technique, commercial ? »)
score: une échelle ordonnée (« impact client : aucun, mineur, majeur, critique »)
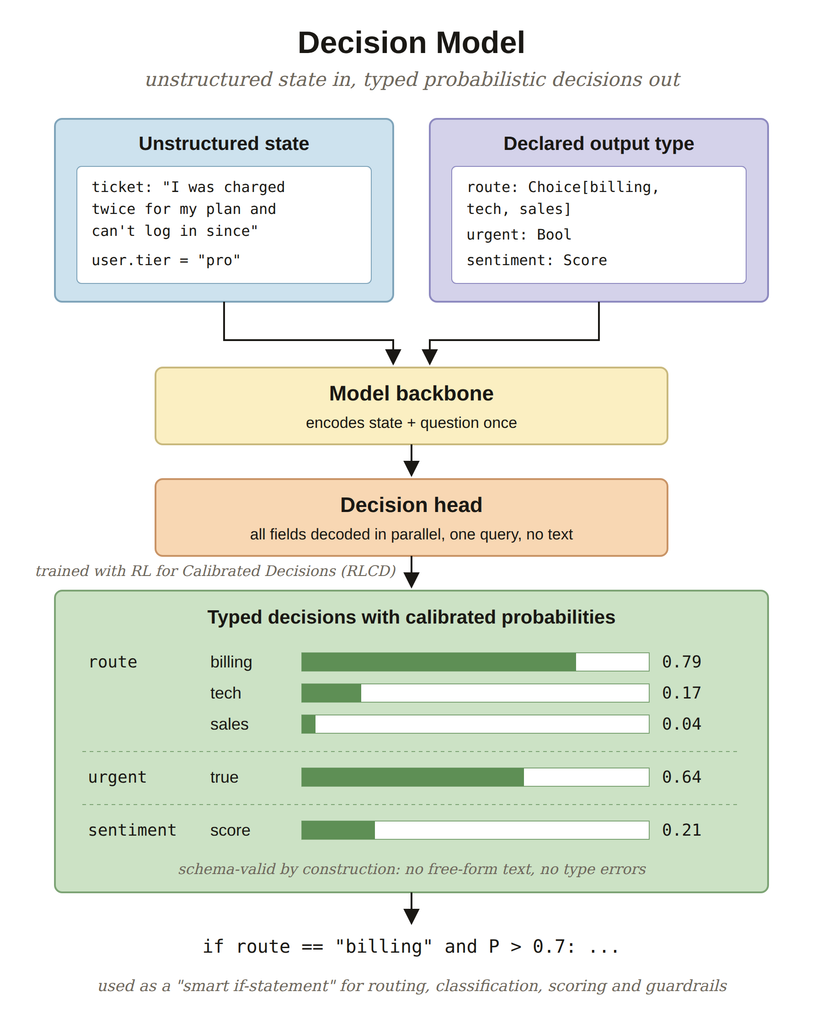
Concrètement, un seul appel peut poser jusqu’à 64 questions sur le même état. La réponse arrive en une seule passe : le modèle lit l’état, puis une tête de classification note toutes les options de toutes les questions en même temps.
Pour les plus techniques : le cours Hugging Face détaille cette structure. Il montre comment le corps du modèle produit une représentation de l’entrée, que la tête projette ensuite vers la sortie voulue (Behind the pipeline).
TypeSafe, qui a lancé le terme, parle de System One Models, en référence au « Système 1 » de Kahneman : la pensée rapide et intuitive, par opposition au raisonnement lent et délibéré des LLM qui « réfléchissent ».
Pour suivre les publications et les benchmarks de cette nouvelle catégorie, Papers with Code lui consacre désormais une page dédiée.
Decision model vs LLM
La différence tient en une phrase : un LLM produit une chaîne de caractères qu’il faut ensuite interpréter, un decision model produit directement une valeur que le code peut utiliser. Tout le reste en découle.
| LLM | Decision model | |
|---|---|---|
| Sortie | Texte libre, à parser et valider | Valeur typée, définie à l’avance |
| Génération | Séquentielle, token par token | Une seule passe, toutes les réponses en parallèle |
| Erreur de format | Possible (catégorie inventée, JSON cassé) | Impossible par construction |
| Confiance | À demander dans le prompt, souvent surestimée | Probabilité calibrée sur chaque réponse |
| Latence | De quelques secondes à plusieurs minutes avec raisonnement | 8 ms à 500 ms selon le modèle et le matériel |
| Coût | Tokens d’entrée + tokens de sortie (plus chers) | Tokens d’entrée uniquement, sortie gratuite |
| Ce qu’il sait faire | Écrire, résumer, coder, raisonner longuement | Classer, router, noter, vérifier |
Deux points méritent qu’on s’y arrête.
Le format garanti. Avec un LLM, même en sortie structurée, il reste une probabilité non nulle que la réponse sorte du cadre. Un decision model ne peut renvoyer que les options déclarées : la question ne se pose plus.
La probabilité exploitable. C’est, à notre avis, le vrai changement. Un modèle juste à 95 % mais incapable de dire quand il se trouve dans les 5 % restants ne peut pas automatiser une tâche sans relecture systématique. Une probabilité calibrée permet d’écrire : au-dessus de 0,9 on traite automatiquement, en dessous on envoie à un humain. C’est exactement ce dont un process métier a besoin.
Où un decision model fait mieux qu’un LLM
La règle simple : dès que la réponse attendue tient dans une liste fermée, et que la décision se répète des milliers de fois, un decision model est probablement le bon outil. TypeSafe parle de « if-statements intelligents » : des conditions floues insérées dans du code classique, là où une règle écrite à la main serait trop fragile.
- Tri et routage. Qualifier un ticket support, une demande entrante ou un email : urgence, équipe, sentiment, intention. C’est l’exemple de la documentation Cloudflare, et le cas le plus évident.
- Traitement documentaire. Sur une facture, un contrat, un justificatif : le document est-il complet, conforme, lisible ? Quelle action déclencher ? Clef obtient ses meilleurs résultats sur ce type de workflow (traitement de factures, revue de clauses contractuelles).
- Détection de fraude et d’anomalies. Noter un dossier, une transaction ou une déclaration sur plusieurs critères à la fois, avec une probabilité qui alimente directement un seuil d’alerte.
- Garde-fous autour des LLM. Vérifier qu’une réponse générée n’hallucine pas, détecter une tentative de contournement, juger la qualité d’une sortie. Le decision model devient le contrôleur rapide et peu cher d’un LLM plus lent.
- Routage d’agents. Choisir le bon outil ou le bon sous-agent dans une architecture multi-agents, en quelques dizaines de millisecondes au lieu d’un appel LLM complet.
- Traitement de masse. Passer des millions de lignes, d’avis clients ou d’enregistrements pour en extraire des étiquettes ou des scores. À ce volume, l’écart de coût et de vitesse change ce qui est économiquement faisable.
- Temps réel et edge. Avec d1-3B, Liquid AI répond à une question en 16 ms sur une carte Jetson embarquée. Cela ouvre la modération vidéo en direct, le contrôle qualité sur ligne de production, la robotique : des cas où un aller-retour vers une API LLM est tout simplement trop lent.
Point commun : la décision est décomposable. Les workflows les plus fiables posent beaucoup de petites questions indépendantes, puis combinent les probabilités dans le code. C’est plus robuste qu’une grande question confiée à un LLM qui « raisonne » tout seul.
Où ce n’est pas pertinent
Un decision model n’est pas un LLM moins cher. C’est un outil différent, et il y a des cas où il ne sert à rien.
- Tout ce qui produit du texte. Rédiger un email, résumer un rapport, répondre à un client, générer du code : un decision model ne génère rien. Il peut décider quel modèle de réponse envoyer, pas l’écrire.
- Les réponses ouvertes. Si vous ne pouvez pas lister les options à l’avance, il n’y a pas de schéma à donner. Extraire un montant, un nom ou une date libre reste un travail de LLM ou d’extraction classique. Jev plafonne d’ailleurs à 255 options par question.
- Le raisonnement difficile. Sur les benchmarks de raisonnement exigeant (GPQA Diamond, questions scientifiques de niveau doctorat), Clef tombe à 48 % quand Jev atteint 78 %. Une décision rapide reste une décision rapide : sur un problème qui demande plusieurs étapes de réflexion, un LLM avec raisonnement garde l’avantage.
- Les décisions rares. Si la décision se prend dix fois par mois, l’écart de coût et de latence ne justifie pas d’intégrer une brique de plus. Un LLM bien prompté, ou un humain, suffit.
- Les règles déjà déterministes. Si un
if montant > 1000fait le travail, aucun modèle n’est nécessaire. Le decision model sert là où la règle est floue, pas là où elle est écrite.
Enfin, la catégorie a quelques semaines. Les benchmarks publiés sont ceux des éditeurs, et TypeSafe reconnaît lui-même que ses gains annoncés (×190 en vitesse, ×440 en coût) sont plutôt le haut de la fourchette. Avant de basculer un process, il faut le tester sur ses propres données.
Combien ça coûte
Le modèle économique change : on ne paie que les tokens d’entrée, la sortie est gratuite puisqu’il n’y a pas de texte généré.
- Cloudflare Clef : 0,24 $ par million de tokens d’entrée. Les images sont converties en tokens (au plus 1 024 par image).
- TypeSafe Jev : 0,042 $ par million de tokens d’entrée, soit 42 $ le milliard.
- Liquid AI d1 : modèles ouverts, gratuits à télécharger. Le coût est celui de votre matériel.
- LLM classiques : de 0,20 $ à 10 $ par million de tokens d’entrée, et des tokens de sortie environ 5 fois plus chers.
Pour fixer les idées, prenons un cas type : 1 million de documents par mois, 1 000 tokens chacun, soit 1 milliard de tokens d’entrée. Côté LLM, on prend Mistral Medium 3.5, modèle phare de Mistral AI (1,50 $ en entrée, 7,50 $ en sortie par million de tokens), qui répond en 100 tokens de JSON, sans raisonnement.
| Modèle | Coût mensuel estimé | Latence par appel |
|---|---|---|
| TypeSafe Jev | ~42 $ | ~0,5 s |
| Cloudflare Clef | ~240 $ | ~0,2 s |
| Mistral Medium 3.5 | ~2 250 $ | ~2 à 3 s |
Ces chiffres sont des ordres de grandeur, pas un devis. Un LLM avec raisonnement activé coûterait plusieurs fois plus, et les prix des éditeurs bougent vite (TypeSafe précise qu’il ne peut pas encore prouver que son tarif n’est pas subventionné).
Auto-hébergement
C’est l’autre option, et elle compte pour les données sensibles. Clef tourne sur un seul GPU H200 sous licence Apache 2.0. d1-3B tient sur une carte graphique grand public ou un module embarqué. Pour une entreprise soumise au RGPD ou à des exigences de souveraineté, faire tourner un decision model chez un hébergeur européen devient réaliste, ce qui n’était pas le cas avec un LLM de pointe.
RGPD
Un decision model traite souvent des données personnelles : un email client, un dossier d’assurance, une pièce justificative. Trois points sont à vérifier. D’abord l’hébergement : Jev n’est accessible qu’en API hébergée aux États-Unis, ce qui implique un transfert hors UE à encadrer, alors que Clef et d1 peuvent tourner sur une infrastructure européenne, voire dans votre propre système d’information. Ensuite l’article 22 du RGPD : une décision fondée exclusivement sur un traitement automatisé, qui produit des effets juridiques ou significatifs pour une personne (refus d’indemnisation, rejet d’un dossier), est en principe interdite, sauf exceptions encadrées qui imposent notamment de pouvoir obtenir une intervention humaine. La probabilité calibrée aide ici : on automatise les cas sûrs et on envoie les cas limites à un humain. Enfin la minimisation : l’état transmis au modèle ne doit contenir que les données nécessaires à la décision.
Les providers
Trois offres, trois positionnements différents.
| Modèle | Éditeur | Taille | Entrées | Distribution | Prix | Latence annoncée |
|---|---|---|---|---|---|---|
| Jev | TypeSafe AI | non communiquée | Texte, données structurées | API propriétaire, accès anticipé | 0,042 $ / M tokens | 70 à 500 ms |
| Clef | Cloudflare | 27B | Texte, JSON, images, vidéo | API Workers AI ou poids ouverts (Apache 2.0) | 0,24 $ / M tokens | ~210 ms (médiane) |
| Clef-Flash | Cloudflare | plus petit | Texte, JSON, images, vidéo | API Workers AI ou poids ouverts | — | ~40 ms (médiane) |
| d1-3B | Liquid AI | 3B | Texte, images | Poids ouverts, llama.cpp | Gratuit (matériel) | 8 ms sur RTX 4090, 16 ms sur Jetson Thor |
| d1-omni-600M | Liquid AI | 600M | Texte + image ou texte + audio | Poids ouverts, expérimental | Gratuit (matériel) | non publiée |
TypeSafe AI a ouvert la voie. Fondé par Diogo Almeida, passé par OpenAI sur les travaux qui ont mené à ChatGPT, il a défini l’API « System One » que les autres ont reprise. Jev est le plus fort des trois sur le raisonnement difficile, mais c’est aussi le plus lent et il n’existe qu’en API, hébergée aux États-Unis.
Cloudflare a pris l’API de TypeSafe telle quelle, et a publié ses poids. C’est l’option la plus complète aujourd’hui : bon niveau, multimodale, utilisable en API ou chez soi. Clef-Flash est la variante rapide, souvent meilleure que Clef sur les workflows simples.
Liquid AI vise l’embarqué. d1-3B est petit, ouvert, et tourne sur à peu près n’importe quel matériel. C’est le choix naturel pour de la vision temps réel ou des appareils déconnectés, moins pour des décisions complexes sur de longs documents.
Avantage pratique : comme Clef reprend l’API de Jev, passer de l’un à l’autre se fait sans réécrire son code. Un standard de fait est en train d’émerger.
Pourquoi c’est une évolution de l’état de l’art
Depuis 2022, la course s’est jouée sur un seul axe : des LLM plus gros, puis des LLM qui raisonnent plus longtemps. Ça a donné des assistants remarquables. Ça n’a pas donné autant d’automatisation qu’annoncé, parce qu’un modèle lent, cher et au format imprévisible s’intègre mal dans un process qui tourne seul.
Les decision models ouvrent un second axe : la même compréhension, mais spécialisée pour décider vite et proprement. Trois ruptures, à notre sens :
- L’IA devient une fonction, pas un interlocuteur. On ne converse plus avec le modèle, on l’appelle comme n’importe quelle fonction typée. C’est ce qui permet de l’intégrer dans du logiciel existant sans couche de parsing fragile.
- L’incertitude devient une donnée. La probabilité calibrée transforme le « le modèle se trompe parfois » en un seuil réglable entre automatisation et contrôle humain. Pour un secteur régulé, c’est ce qui rend un process auditable.
- Le coût de la décision s’effondre. À quelques dizaines de dollars le milliard de tokens, on peut appliquer de l’IA sur des volumes où personne ne l’aurait envisagé. TypeSafe a baptisé son modèle Jev en référence à Jevons : quand une ressource devient beaucoup moins chère, on en consomme beaucoup plus.
Ce n’est pas pour autant la fin des LLM. L’architecture qui se dessine combine les deux : le decision model trie, route et contrôle en continu, le LLM intervient uniquement là où il faut écrire ou raisonner. C’est la même logique que dans une équipe : les décisions de routine se prennent vite, les cas complexes remontent.
Ce qu’il faut retenir
- Un decision model renvoie une décision typée avec sa probabilité, pas du texte.
- Il est des dizaines de fois plus rapide et moins cher qu’un LLM sur les décisions à options fermées.
- Il ne remplace pas un LLM pour écrire, extraire des valeurs libres ou raisonner longuement.
- Les modèles ouverts (Clef, d1) permettent un hébergement en Europe, sur ses propres serveurs.
- La catégorie a quelques semaines : on teste sur ses propres données avant de basculer.
Chez IALab, nous construisons des systèmes IA en production pour des PME et ETI, souvent dans des secteurs où chaque décision doit être traçable : assurance, finance, juridique. Si vous avez un process qui repose aujourd’hui sur un LLM pour trier, classer ou valider, c’est le bon moment pour mesurer ce qu’un decision model changerait. Parlons-en.
Sources
- Liquid AI, Open d1: Edge decision models for text, vision, and audio, 7 octobre 2026
- Cloudflare, documentation du modèle Clef sur Workers AI
- Cloudflare, fiche du modèle Clef sur Hugging Face (architecture, licence, benchmarks)
- TypeSafe AI, Introducing System One Models & Jev
- Papers with Code, Decision Model : publications et benchmarks